Google DeepMindとMoment Factory、生成AI映像を巨大空間で検証
両社がドームと歴史建築で生成AI映像を試験。大画面で生じる破綻を抑えるタイル方式を探りました。
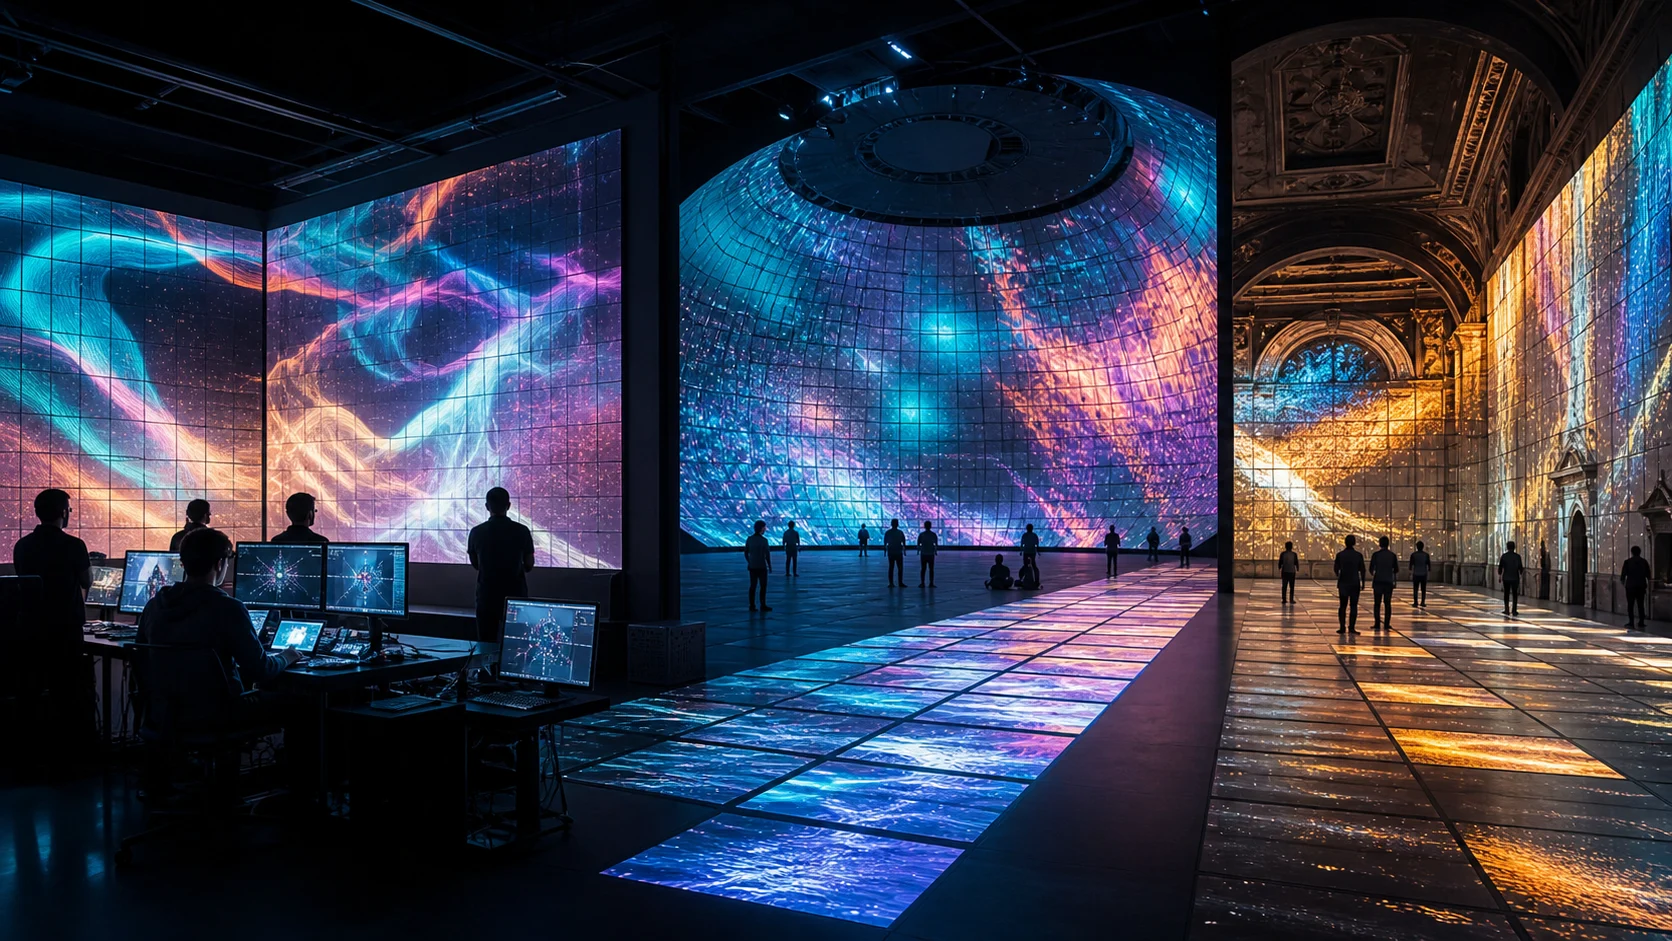
Moment Factoryは2026年7月20日、Google DeepMindと行った生成AI映像の空間実験を公表した。問いは「生成AI動画が画面の外へ出たら何が起きるか」。ドームや建築へ投影すると、表示面は大きくなり、壁の凹凸も映像に影響する。観客が映像へ近づくため、小さな乱れも目立ちやすい。両社は研究者、アーティスト、技術者によるチームを組み、実在する複数の会場で限界を確かめた。
小さな違和感が「10メートル幅の破綻」になる
Moment Factoryが持ち寄ったのは、大規模なロケーションベース体験を設計・制作してきた現場の制約である。Google DeepMindはマルチモーダルモデルとワールドモデルを含むAIの知見を提供した。検証はモントリオールのMoment Factory AI Studioから始まった。次に、Society for Arts & Technology(SAT)が運営する没入型ドーム「Satosphère」で試した。最終段階ではニューヨークのCipriani 25 Broadwayへ移り、装飾の多い歴史的建築への投影を試したという。
発表で具体的に挙げられた課題は三つある。第一に、画面では見逃される小さなグリッチが、没入空間では「幅10メートルの裂け目」になり得ること。第二に、再生時間が長くなるほど映像の反復が露出すること。第三に、人はパターンの不自然さを見つける能力が高く、巨大な表示面ほどその違和感を隠しにくいことである。建築は単なるスクリーンではない。壁面のテクスチャーや形状、空間内での視線の移動が、映像の見え方と錯覚の持続を変える。
背景には、生成AI動画が主に短いクリップ、標準的なスクリーン、制御しやすい視聴条件の中で発展してきたという両社の認識がある。モデルの進歩によって映像は鮮明になり、グリッチは減り、リアリティーも高まってきた。しかし公式発表は、それらが「画面上」での成果である点を区別する。大きな建築面に重ね、観客が歩きながら長時間見る条件へ移すには、出力品質を上げることとは別の検証が必要だった。
チームが到達した手法は、メガキャンバスをより扱いやすい小単位に分割するモジュラー・タイリング・システムだ。公式発表は、この方式が鮮明なディテール、高い忠実度、強い画素密度を維持することを狙うと説明する。一枚の巨大映像をそのまま拡大するのではなく、空間に合わせて生成・配置を扱う発想であり、表示規模に伴う品質管理を制作工程に組み込む試みといえる。
生成後の映像はアーティストが空間へ合わせる
このシステムは完全自動の生成装置として発表されたものではない。Moment Factoryは、最終的な判断をアーティストに残すと説明している。生成した映像を物理空間へ合わせて変形し、引き伸ばし、動きを調整する工程には人が関わる。モデル名、入力条件、解像度、実装ソフトウェア、一般提供の時期は公表されていない。また、実験で得た手法が常設施設や商用案件に導入済みであるとの発表もない。現時点で確認できるのは、共同実験で得た制作方法までだ。
製品名や商用施設への導入予定は未公表
今回の発表は、生成AI映像を巨大な壁面やドームへ映す際の問題と、その対処方法を紹介したものだ。タイルの境界をどう処理したか、長時間のループ再生でどの程度まで反復を抑えられたかといった試験結果は公表されていない。著作権や生成素材の管理方法についても説明はない。
両社は、この方法を製品として一般提供する時期や、商用施設へ導入する予定を示していない。現段階では、モントリオールのスタジオとドーム、ニューヨークの歴史的建築で行った共同実験である。常設のLBE施設で使われるかどうかは、今後の発表を待つことになる。